之前只大概了解了一下 RoPE,并没有完全搞明白原理,又重新思考了一遍
RoPE 实际上就是对在对每一个 token 的 q 和 k 融入绝对位置信息,使得在计算 attention q 和 k 的内积的时候会自动具备 token 的相对位置信息。
原理
实际上怎么做的呢?我们以 2 维向量为例,2 维向量 Q=(q1,q2) 可以用虚数表示为 q1+q2i,我们可以发现 Q⋅K,也就是 Q 和 K 的点积 (q1k1+q2k2) 可以表示为 Re(Q∗K),也就是 Q 的共轭复数和 K 的乘积再取实部。也就是说
Q⋅K=Re(Q∗K)
RoPE 将 Q 融入位置信息例如 m,K 融入位置信息例如 n,通过
Qm=Q⋅eimθ
这里 θ 暂时不做介绍,可以理解为一个固定参数用来调节位置信息。
2 维向量的复数表示还可以写成极坐标形式 Q=qeiα,这里 q 代表 Q 向量的模长,α 代表向量相对于 x 轴的方向角(幅角)。复数的极坐标做乘法运算,模长相乘,幅角相加。也就是说上式的操作实际上是在对 Q 向量旋转 mθ。
Qm=qeiα⋅eimθ=qei(α+mθ)
Kn=K⋅einθ=kei(β+nθ)
这个算法为什么有效?我们可以将上式用第一个式的方法做个运算。
Qm⋅Kn=Re(Qm∗Kn)=Re(qei(−α−mθ)⋅kei(β+nθ))=Re(qkei[(n−m)θ+(β−α)])
根据欧拉公式:
eiφ=cosφ+isinφ
代入欧拉公式得
Re(qkei[(n−m)θ+(β−α)])=qkcos[(n−m)θ+β−α]
上式里面,只有 (n−m)θ 是加入位置信息之后得到的,其他的都是原本就有的信息。这里可以看出我们通过旋转,很好的将相对位置信息在 attention 计算中展现出来了。
如何做
我们现在要将 Qm=Q⋅eimθ 实现(K 也是一样)
这里也用欧拉公式将 eimθ 展开
如何处理复数呢,将原本的 Q 展开成复数形式 Q=q1+q2i
算出来
(q1cosmθ−q2sinmθ)+(q1sinmθ+q2cosmθ)i
也就是说
q1∗=q1cos(mθ)−q2sin(mθ)
q2∗=q1sin(mθ)+q2cos(mθ)
那我们可以用 [cos(mθ)sin(mθ)−sin(mθ)cos(mθ)] 乘以 [q1q2] 就可以得到 q1∗ 和 q2∗ 了
实际上我们的向量是多维向量,一般是 128,不止是 2 维。那么如何处理呢
我们可以发现,多维向量的向量积可以拆分成多个 2 维向量的向量积的和。
比如 (q1k1+q2k2)+(q3k3+q4k4)+(q5k5+q6k6)+…
所以我们乘以一个这样的矩阵就可以了
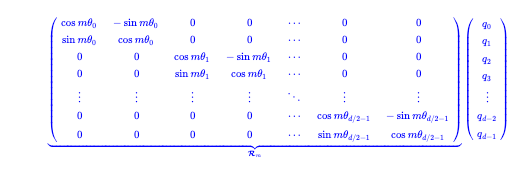
这样就等于把 q、k 两个向量分成了很多 2 维向量的小块,然后再来算相似度。位置信息融入了每一个小块当中。
然后我们再来考虑 θ。我们先假设 θ=1。这样当 nθ=mθ+2π 的时候,位置信息就完全失效了,因为把 K 旋转的角度和 Q 旋转的角度重合了。(弧度制一圈是 2π)
RoPE 这里把 θi 设置成了 10000−2i/d,其中 i 是每一个 2 维向量的组数(第几组),d 是 Q 和 K 向量的维度(dk,一般是 128)。这个 θi 就像每一个组的旋转速度,前面的小组转的快,后面的小组转的慢,可以想象成秒表、分表、时表、日表、周表、月表、年表等等。过的时间实际上是一样的,但是有些转了好几圈,有些就转了一点点。
这样想要让旋转完全重合,就要满足
nθ0=mθ0+2kπ, nθ1=mθ1+2kπ, … (θ∈[0,d/2−1])
这样就很难重合。
至于为什么是这个数字,从理论上来说,只要这些 θi 互不相同,RoPE 就能 run 起来,之所以选择 10000−2i/d 这个函数是因为这个函数先被 GPT 选择使用了,结果出奇的好。
从科学的角度来看是这个函数会带来一定的远程缩减性,
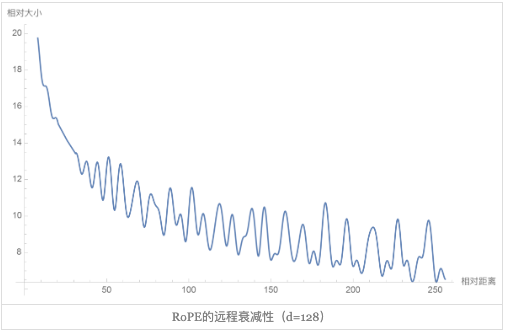
我们在”原理”中的最终公式:
Re(qkei[(n−m)θ+(β−α)])=qkcos[(n−m)θ+β−α]
可以看到这个位置信息是融入到 cos 中的,当 n-m 很大的时候,我们的很多位置在前面的 2 维向量小块都不知道转了多少圈了,我们最后算的是累和,cos 的值是会相互抵消的,我们把范围拉大的时候,就会有很多小组之间在互相抵消,最后导致整个累和的值很小。也就是说位置里的越远的 token 之间的相似性会更小。
这里 RoPE 的作者说道:”能带来远程衰减性的不止这个选择,几乎任意的光滑单调函数都可以,这里只是沿用了已有的选择而已。笔者还试过以 θi=10000−2i/d 为初始化,将 θi 视为可训练参数,然后训练一段时间后发现 θi 并没有显著更新,因此干脆就直接固定 10000−2i/d。”
这里还会出一个问题,也是由于这个远程衰减性,我们会发现由于会互相抵消,当 n-m 很大的时候,位置信息实际上只看后面几个 2 维向量小组的了,当最后一个 2 维向量小组也开始出现重复的时候,这个位置信息的表达就会开始出现问题。
目前这个 10000−2i/d 大概在 62831 个 Token 就会出现以上问题,在大模型越来越强的时代有些不够用了,所以还有很多基于此改进的研究,比如将 10000 改成 80000。还有很多奇妙小技术,比如 YaRN。之后再继续探索吧。